KILLOOS
Интеллектуальная система бизнес-аналитики, переводит данные в управленческие решения и предупреждает риски до потерь.
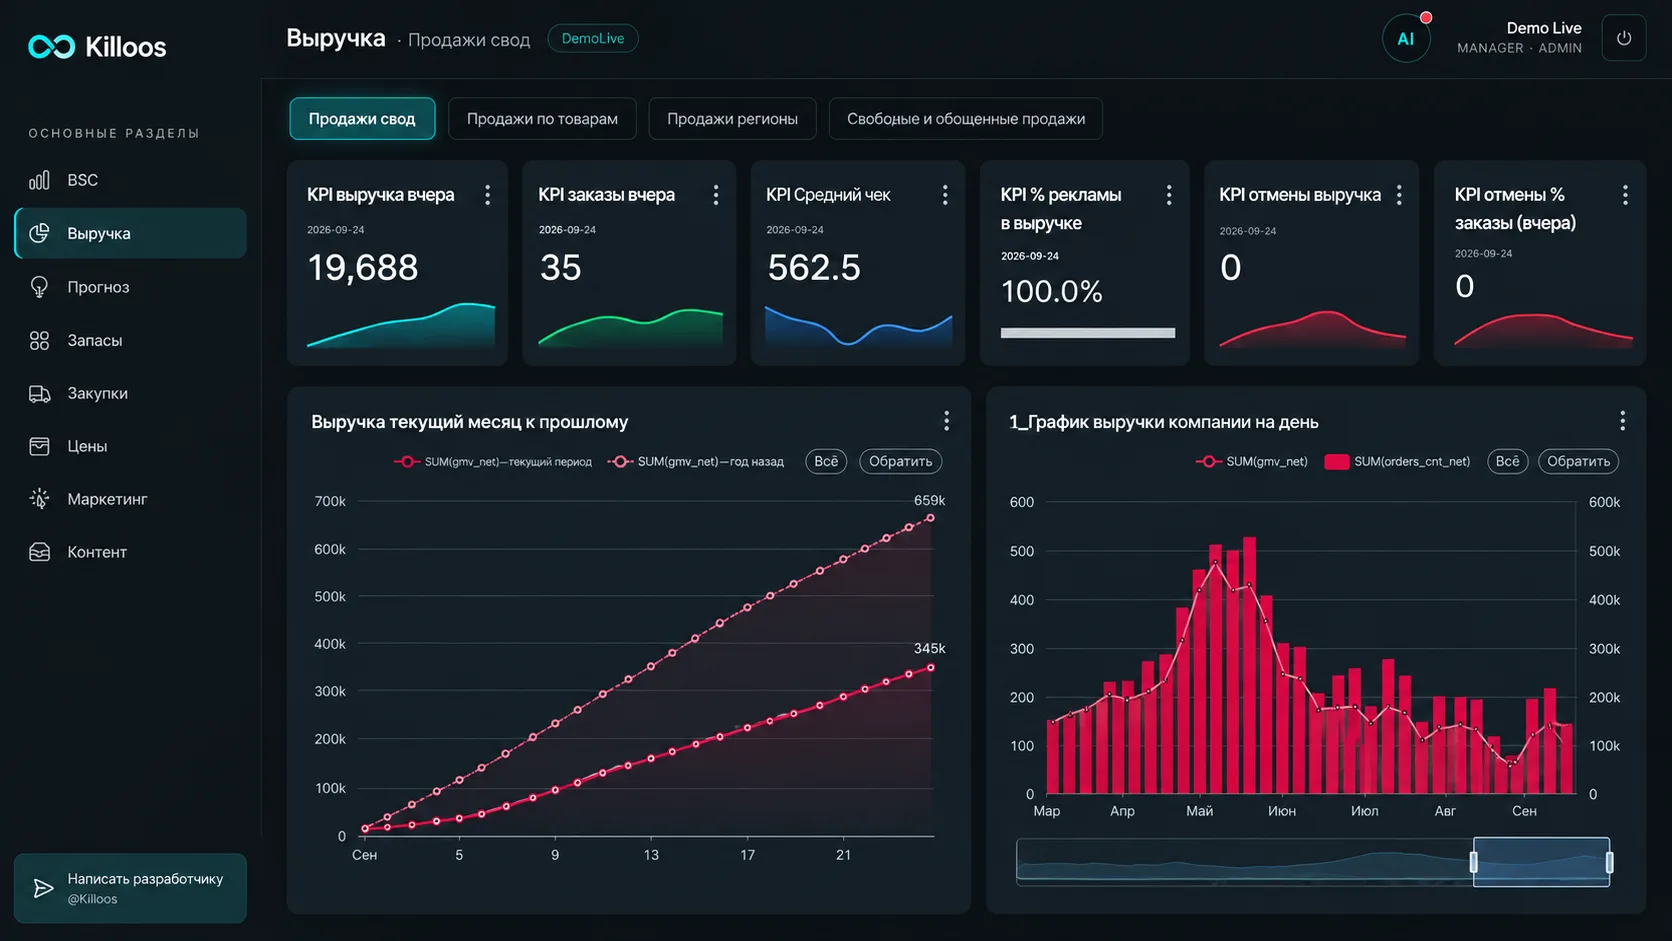
KILLOOS — подробно
Инструментарий, который собирает данные из разных источников бизнеса — маркетплейсов, CRM, склада, рекламы, собственных систем учёта — в один персональный дашборд, сам находит отклонения и объясняет их человеческим языком, а не отдаёт каждую интеграцию на отдельную кастомную разработку.
Вместо того чтобы утром открывать несколько кабинетов и выгрузок и пересчитывать всё в Excel, пользователь открывает один экран, где уже посчитано, что произошло за сутки и что с этим делать — а состав дашборда и роли доступа сотрудников настроены под структуру именно его команды.
Кратко о проекте
KILLOOS — платформа бизнес-аналитики для владельцев и операционных руководителей, которым нужно принимать решения по цифрам каждый день, а данные для этого лежат в разных источниках — на маркетплейсах, в CRM, на складе, в рекламных кабинетах и собственных системах учёта.
Продукт закрывает три смежные проблемы: данные живут в разных источниках и форматах; отклонения в продажах или остатках заметны не сразу, потому что их никто не мониторит постоянно; а получить ответ на конкретный вопрос по цифрам без специалиста, который умеет писать SQL-запросы, обычно невозможно.
Ключевая идея заметна прямо в архитектуре: искусственный интеллект здесь работает поверх честной инженерии, а не вместо неё. Сначала детерминированный расчёт — отклонения от среднего, от плана, от прошлой недели, — и только потом поверх уже посчитанных цифр языковая модель формулирует объяснение и рекомендацию. Если модель недоступна или отвечает некорректно, система показывает версию, посчитанную по правилам, а не останавливается.
Продукт устроен не как один жёсткий шаблон, а как конструктор из шести функциональных блоков — KPI, BI, AI, Reports, Alarm, Drill, — из которых под конкретный бизнес собирается свой набор. Платформа подключает несколько источников данных, строит витрины и связи между ними, а методика расчёта показателей и роли доступа сотрудников настраиваются индивидуально под структуру команды. Изначально контур обкатывался на данных Ozon как на живом, а не синтетическом полигоне — но у площадки часто меняется формат выгрузок и API, и продукт вырос из «сервиса под конкретный маркетплейс» в источнико-независимый конструктор дашбордов.
Задача / проблема
У бизнеса с несколькими каналами продаж данные обычно разбросаны: отчёт по продажам приходит одним файлом из одной системы, остатки по складам — другим, отзывы покупателей — отдельной ручной выгрузкой (у многих маркетплейсов нет полноценного API для отзывов, только экспорт), возвраты — ещё одним файлом из третьей системы. Источники приходят как малоструктурированные текстовые выгрузки, которые нужно приводить к единому виду, прежде чем с ними можно работать.
Даже когда данные сведены вручную, без выделенного аналитика просадка выручки, рост доли отмен или товар, который вот-вот закончится на складе, замечаются с задержкой — когда кто-то вручную открывает отчёт и сравнивает с прошлым периодом. Третья проблема — порог входа: собственник или менеджер, который не пишет SQL, не может быстро задать вопрос вроде «какая выручка была в августе по сравнению с июлем» без похода к аналитику.
Решение
Базовая идея — выстроить цепочку из источников данных, слоя обработки и AI-надстройки, где каждый слой отвечает только за свою задачу:
Источники данных (маркетплейс, интернет-магазин, CRM) → ETL-конвейер (сырые данные → нормализация → бизнес-факты → витрины) → AI-слой (детектор аномалий, ежедневная интерпретация, вопросы на естественном языке) → интерфейс (дашборды, чат, мобильные сводки).
Данные проходят через ETL, приводятся к единому формату и превращаются в чистые витрины. Дальше поверх витрин работает два независимых AI-контура — один каждый день ищет отклонения и переводит их в человеческий текст, второй отвечает на произвольные вопросы на естественном языке. Ни один из них не имеет прямого доступа к «сырым» данным — оба работают только с уже очищенными витринами.
Как работает
Шесть блоков конструктора
Продукт собирается из шести функциональных блоков, а не поставляется одним неделимым куском — под конкретный бизнес включается свой набор:
- KPI — фиксация ключевых показателей и правил контроля именно для этого бизнеса.
- BI — управленческие дашборды (Superset или Power BI).
- AI — детектор отклонений, ежедневные сводки, ответы на вопросы естественным языком.
- Reports — ежедневные и еженедельные дайджесты в Telegram или на почту.
- Alarm — мониторинг показателей и алармы при отклонениях.
- Drill — AI-ассистент, к которому можно обратиться в чате или голосом за конкретной цифрой.
Роли и доступ
Доступ к дашбордам и данным разграничен по ролям и уровню ответственности — под структуру команды конкретного бизнеса, а не по одному общему аккаунту на всех. Владелец видит сводную картину, руководитель направления — свой участок, сотрудник — только то, что относится к его задачам.
Сбор и нормализация данных
Данные забираются из источников (выгрузки маркетплейса, API-интеграции, данные интернет-магазина) и проходят четырёхслойный конвейер: сырые данные как есть → нормализация типов и полей → очищенные бизнес-факты → готовые витрины для дашбордов и AI-агента. Каждый запуск логируется, повторный запуск не создаёт дублей.
Детектор аномалий (Health Scoring)
Каждый день по ключевым метрикам — выручка, число заказов, доля отмен — система считает отклонение от среднего за 7 дней, от вчерашнего дня, от того же дня неделю назад и от плана. Отклонения штрафуются по порогам и взвешиваются по важности метрики, сумма даёт итоговый показатель и раскраску дня — зелёный, жёлтый или красный. Это чистая арифметика без участия языковой модели — детекция риска должна быть воспроизводимой каждый день одинаково.
Ежедневная AI-сводка
Раз в день по компании строится текстовая интерпретация состояния бизнеса: статус, тенденция, краткое описание, ключевые находки, рекомендованные действия. Базовая версия считается детерминированными правилами из снэпшота показателей — гарантированный минимум, который есть всегда. При включённом режиме с языковой моделью она может переписать этот текст естественнее, сохраняя структуру; при сбое или невалидном ответе сохраняется версия по правилам, а какая именно версия использована — фиксируется отдельным полем.
Вопросы на естественном языке (text-to-SQL)
Пользователь задаёт вопрос обычным языком — например, «какие продажи сегодня». Частые типовые вопросы система узнаёт по заранее описанным паттернам и строит запрос напрямую, без модели. Для нового вопроса — связка ролей: одна модель превращает вопрос в структурированный план, вторая сопоставляет его с реальными таблицами по списку разрешённых объектов, третья формулирует ответ на русском. Перед выполнением запрос проверяется: разрешено только чтение, обращение к таблицам вне списка блокируется.
Семантический поиск и классификация отзывов
Система хранит словарь метрик и базу вопрос-ответ с векторными представлениями текста и ищет ближайшие по смыслу записи, а не по точному совпадению слов — это помогает распознать вопрос, заданный не точным термином. Отдельно языковая модель классифицирует отзывы покупателей по категории проблемы (товар, доставка, комплектация, карточка товара, сервис), а тональность считается отдельно и жёстко по оценке в звёздах — так видно, что у товара накопилось много жалоб одного типа, без ручного чтения каждого отзыва.
Кастомные AI-агенты для отдельных клиентов
Для клиентов с собственной базой данных поднимается изолированный AI-агент со своим набором разрешённых таблиц и пакетом знаний о бизнесе — новый клиент подключается конфигурацией доступа, без изменения кода платформы.
Ключевые особенности
- Детектор и объяснение разделены. Отклонения считаются арифметикой, языковая модель только описывает уже посчитанный факт — сводка не может «придумать» цифру.
- Гарантированный fallback. Если модель недоступна или отвечает некорректно, сводка всё равно формируется по правилам, и в записи видно, какая версия использована.
- Защита от опасных запросов. Сгенерированный SQL-запрос проверяется перед выполнением: разрешено только чтение и только из заранее одобренного списка таблиц.
- Разделение ролей между моделями по стоимости. Структурные шаги отдаются более дешёвой и быстрой модели, связный текст для пользователя — более качественной.
- Поиск метрик по смыслу вопроса, а не по точному совпадению слов.
- Конструктор, а не один шаблон. Один продукт собирается из шести блоков (KPI, BI, AI, Reports, Alarm, Drill) под конкретный бизнес и работает как с типовыми источниками, так и с кастомными клиентами со своей базой данных.
Техническая реализация
Конвейер данных реализован на Python поверх PostgreSQL без внешнего оркестратора — для объёма задач одного продукта это проще эксплуатировать, чем разворачивать отдельный кластер; идемпотентность держится на upsert-операциях и уникальных индексах.
Ключевое архитектурное решение вокруг text-to-SQL-агента — он не имеет прямого доступа к схеме базы данных, а работает только с заранее подготовленным описанием разрешённых таблиц, полей и связей. Это устраняет главный риск подхода «текст в SQL» на уровне архитектуры, а не только за счёт финальной проверки запроса. Роли между несколькими языковыми моделями разделены по стоимости и сложности задачи осознанно, а не случайно. Семантический поиск реализован прямо в PostgreSQL через векторное расширение, без отдельной специализированной векторной базы — для объёма данных одного продукта отдельный сервис избыточен.
Ежедневная AI-сводка спроектирована так, чтобы языковая модель никогда не была единственным источником текста: режим генерации (по правилам, с моделью, или fallback при её сбое) фиксируется как отдельное поле записи, что делает результат проверяемым постфактум. По тому же принципу выстроена классификация отзывов — строгий структурированный формат ответа модели с повторной попыткой при невалидном ответе.
Прогноз спроса, синтез речи и BI-дашборды — более локальные модули вне основного AI-контура. Прогноз спроса остаётся исследовательским и не подключён к продакшен-интерфейсу; синтез речи и встраиваемые дашборды — рабочие, подключены через внешние сервисы и готовую BI-платформу.
Технологический стек
Python, FastAPI — backend и REST API продукта.
PostgreSQL — единая база для оперативных данных, аналитических витрин и векторного поиска.
pgvector — расширение PostgreSQL для семантического поиска по метрикам и Q&A.
React, Next.js — веб-интерфейс продукта.
OpenRouter — единая точка доступа к нескольким языковым моделям, маршрутизация по ролям задачи.
Эмбеддинги OpenAI — векторные представления текста для семантического поиска.
Yandex SpeechKit — синтез речи для голосовой озвучки сводки.
CatBoost, Prophet — прогнозирование временных рядов (исследовательский контур).
Apache Superset, Power BI — встраиваемые дашборды и визуализация данных.
Docker Compose, nginx — контейнеризация и развёртывание сервисов.
Что получилось
Данные из разных источников — продажи, остатки, отзывы, возвраты — сведены в единый конвейер обработки: не нужно вручную сверять выгрузки из разных кабинетов и файлов разного формата. Детектор отклонений работает автоматически каждый день без участия человека и раскрашивает день по риску ещё до того, как кто-то открыл дашборд вручную.
Любой сотрудник может получить ответ на вопрос по данным компании на обычном русском языке, не обращаясь к разработчику; частые вопросы обслуживаются мгновенно и без обращения к языковой модели. Результаты работы языковых моделей — классификация отзыва, сводка, ответ на вопрос — сохраняются как обычные записи в базе с пометкой, какой моделью и в каком режиме они получены, а не остаются разовым ответом, который негде посмотреть повторно.
Платформа одновременно обслуживает типовые источники данных и отдельных кастомных клиентов со своей базой данных — без разделения на разные кодовые базы. Модуль работы с отзывами доведён до рабочего состояния и используется как эталонный паттерн для следующих модулей.
Где можно использовать
Подход не ограничен одним продуктом на маркетплейсе — он подходит для любого бизнеса, где данные разбросаны по нескольким источникам, а отклонения нужно замечать быстро:
- Продавцы на маркетплейсах с несколькими каналами продаж (FBO/FBS, разные площадки) — сведение выгрузок в единую картину.
- Интернет-магазины, у которых данные о продажах, маркетинге и клиентах живут в разных системах (CRM, аналитика, реклама).
- Компании без выделенного аналитика или BI-команды, которым нужен постоянный мониторинг ключевых показателей.
- Поставщики аналитики для нескольких клиентов, которым нужна кастомизация под заказчика без форка продукта под каждого.
Похожая задача с данными?
Разберём, что у вас уже собирается, чего не хватает для решений, и что можно проверить первым — за дни, а не за квартал.
Ещё в портфолио
Vizgen
Визуальный редактор для работы с контентом: генерация карточек товара, визуализация и апскейл — доставляется через REST API.
Подробнее →Georeis
Диспетчеризация доставки и приложение водителя: маршрут по фото путевого листа → оптимизированный план на день.
Подробнее →Geo101
Приложение для активных путешественников: GPX-маршруты и офлайн-навигация для трейла, эндуро и пешего туризма.
Подробнее →Kitchen 3D Planner
Планировщик кухни для мебельных компаний: подбор модулей, фасадов и техники по размерам помещения, с 3D-сборкой на выходе.
Подробнее →Driver.Georeis
Приложение для водителей Georeis: распознаёт адреса с фото путевого листа, сверяет по адресной базе и строит порядок объезда с расчётом времени прибытия.
Подробнее →OpenSEO
Генерация SEO-статей по заданной структуре — с очеловечиванием стиля и независимой валидацией результата перед публикацией.
Подробнее →DeviceHub
Единый сервис метрик для физических устройств на столе: тянет данные сразу из нескольких продуктов и отдаёт готовые экраны без перепрошивки.
Подробнее →Rilso
Рабочее место для упаковки рилсов: из сырого видео — превью, транскрипт, вшитые субтитры, обложка, текст публикации, хэштеги и архив на экспорт.
Подробнее →Лабсервер
Собственный GPU-сервер для тестирования моделей, подбора параметров и сборки MVP в закрытом контуре — без выхода данных наружу.
Подробнее →