OpenSEO
Генерация SEO-статей по заданной структуре — с очеловечиванием стиля и независимой валидацией результата перед публикацией.
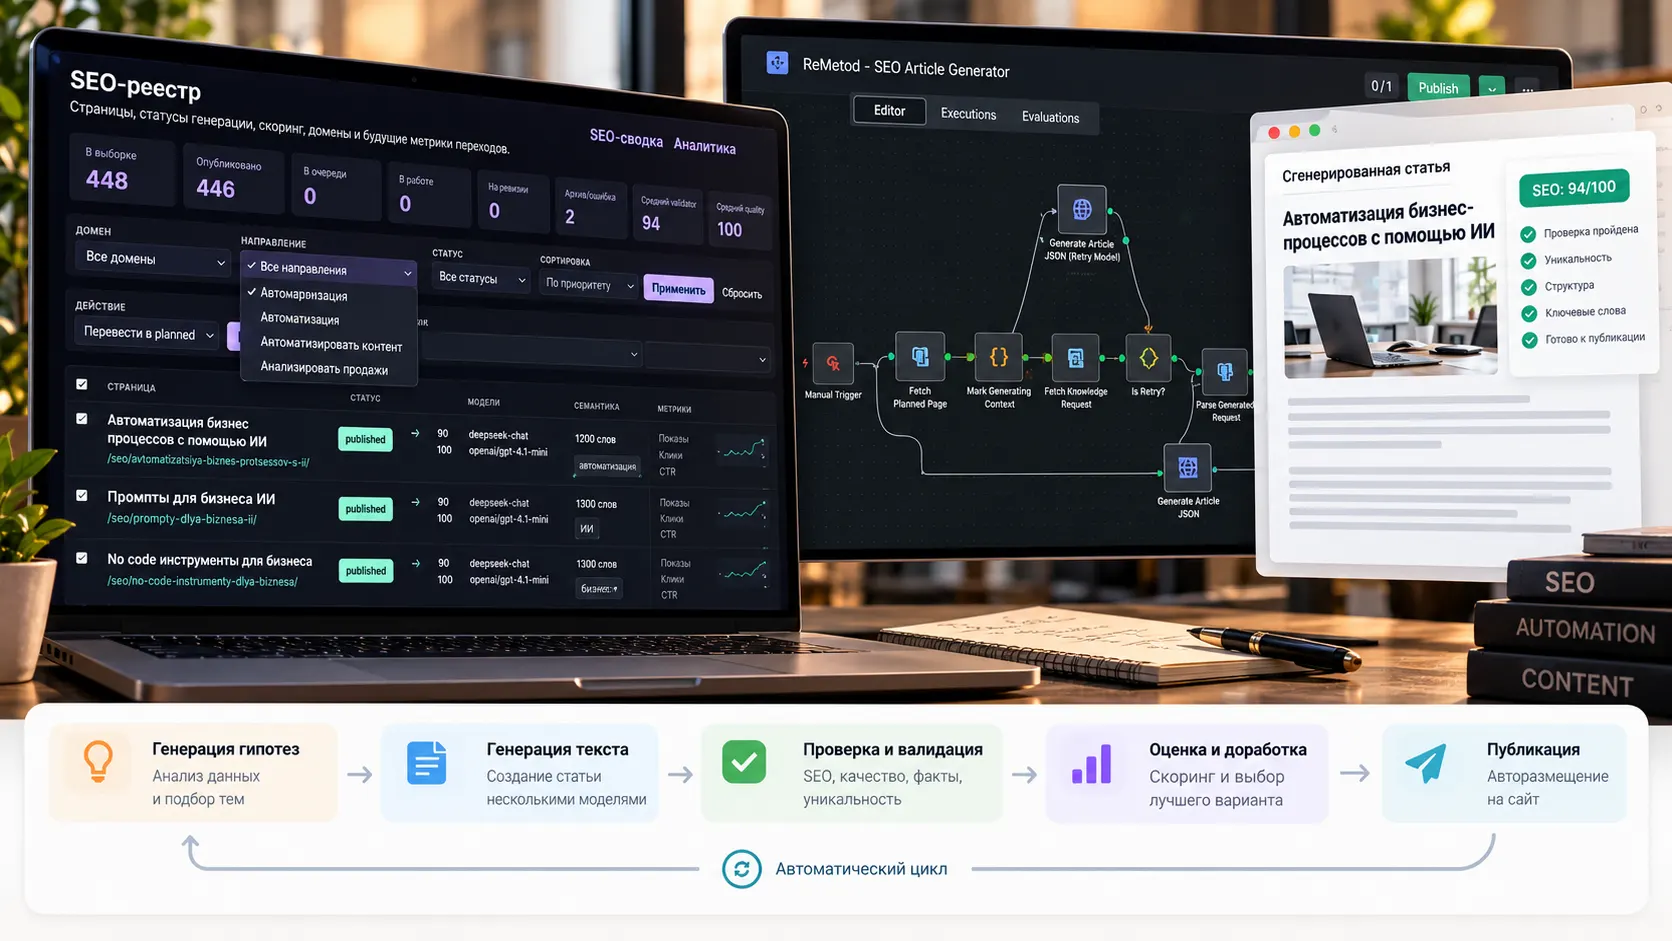
OpenSEO — подробно
OpenSEO — это не чат-бот, который выдаёт текст за один проход, а конвейер из трёх независимых ролей: модель, которая пишет статью, модель, которая её проверяет, и обычный код, который механически сверяет структуру. Статья попадает в публикацию только тогда, когда все три согласны, что она готова — если нет, цикл повторяется, а генератор получает не общее «плохо», а точную инструкцию, что исправить.
Продукт закрывает узкое место программатик-SEO: заполнить раздел сайта сотнями страниц под разные поисковые интенты вручную — это часы работы копирайтера на каждый текст, а просто попросить нейросеть написать статью даёт быстрый черновик, который всё равно приходится вычитывать, потому что модели свойственно выдумывать факты и сползать в шаблонные формулировки.
OpenSEO — часть инфраструктуры ReMetod. На проде через пайплайн прошёл и опубликован реестр из 448 страниц. Отдельно существует раздел /cases — кейсы с версткой и фото, которые пишут люди; они намеренно не проходят через LLM-пайплайн, чтобы не смешивать проверенный вручную контент с автогенерацией.
Задача
Программатик-SEO по природе требует десятков и сотен страниц под разные интенты — определения термина, расчётные методики, разборы кейсов, общие обзоры. Вручную такой объём неподъёмен для одного человека, а прямой заказ у нейросети без контроля превращает задачу в другую проблему: массив шаблонных текстов, которые поисковик и читатель легко считывают как мусор.
Есть и более узкий риск, особенно дорогой для B2B-контента: генеративная модель может выдумать цифру — показатель или кейс клиента, которого не было, — либо привести расчёт без числового примера и без указания источника. Даже когда текст в целом читается неплохо, брак прячется в деталях, которые человек при беглой вычитке пропускает: канцелярские клише без объяснения механизма, подмена термина в заголовке, повтор одного примера в разных блоках статьи.
До автоматизации выбор стоял между двумя одинаково затратными вариантами: копирайтер тратит часы на статью и всё равно не гарантирует техническую полноту, либо нейросеть выдаёт черновик, который нужно вычитывать так же тщательно, как если бы его не было вовсе.
Решение
Общая цепочка:
Тема страницы + база знаний → генератор пишет статью по структуре → независимый валидатор оценивает текст → технический гейт проверяет полноту → публикация или новая попытка с точной инструкцией по правке.
Ключевая идея — развести роли так, чтобы они не «договаривались» за спиной друг у друга. Автор текста систематически слеп к собственным ошибкам: та же модель, что выдумала факт или вставила клише, с высокой вероятностью не заметит проблему в своём же тексте. Поэтому валидатор — отдельный вызов с отдельным промптом, который получает только готовый текст и базу знаний, без пометки «это писал я».
Третий участник — не модель, а обычный код: он проверяет то, что LLM ненадёжно считает даже в роли контролёра — точную длину поля, наличие обязательного ключа, совпадение с фиксированным списком значений. Весь цикл, от выборки темы страницы до публикации или возврата на доработку, собран в одном оркестраторе (n8n), без отдельного бэкенд-воркера, дублирующего эту логику.
Как работает
Генератор пишет статью по заданной структуре
Генератор получает основной и вспомогательные поисковые запросы страницы, набор смысловых терминов, класс интента (определение, расчётная методика, кейс, общий обзор) и релевантные записи из базы знаний. На выходе — не свободный текст, а статья, оформленная как заранее заданная структура из нескольких десятков смысловых блоков: проблемный контекст, методология, формулы, примеры, план внедрения, чек-лист, призыв к действию и другие. Глубина блоков зависит от класса интента: страница с расчётом обязана дать формулу и числовой пример со ссылкой на источник, страница-определение — нет.
Первая попытка идёт через DeepSeek — быстрый и недорогой вариант для чистовой генерации по строгой схеме. Повторная попытка выполняется уже через GPT-4.1-mini: на практике зафиксировано, что DeepSeek на retry хуже следует точечным инструкциям по правке. Каждое число в тексте сопровождается пометкой источника — либо ссылкой на запись базы знаний, либо явной отметкой, что это условный пример, а не факт о продукте.
Независимый валидатор оценивает готовый текст
Отдельным вызовом, не тем же диалогом, где шла генерация, статья проверяется по фиксированному набору смысловых критериев: не выдуманы ли факты о продукте, подтверждает ли база знаний сделанные заявления, верны ли расчёты, соответствует ли терминология принятой, звучит ли язык естественно, нет ли шаблонных оборотов, отвечает ли текст на реальный вопрос страницы. Итоговый вердикт — готова, нуждается в доработке или отклонена — считается по жёсткой формуле от самих критериев, а не по общему впечатлению модели.
Валидатору запрещено оценивать структурную полноту — это зона гейта, чтобы два контролёра не дублировали друг друга. Есть и защита от придирок «на вкус»: если валидатор помечает текст как шаблонный, он обязан процитировать конкретную фразу-симптом, а не ссылаться на общее ощущение.
Технический гейт проверяет структуру без единого обращения к модели
Обычный программный код, не LLM-вызов, механически проверяет: заполнены ли обязательные поля под конкретный класс интента, не пуст ли список источников, входит ли целевое действие статьи в допустимый список, не встретилась ли в тексте шаблонная фраза из заранее собранного списка формулировок. Идея в том, что задачи точного счёта и формальной проверки не должны решаться вероятностной моделью — код не ошибается и не тратит токены. Это разгружает и валидатора: он не обязан снижать оценку за то, что блок короткий, — за формальную полноту отвечает гейт.
Цикл самокоррекции
Если статью завернули — гейт или валидатор, — на следующую попытку генератору передаётся не код ошибки, а расшифрованная инструкция, что именно исправить, с задачей точечной правки: сохранить всё, что не упомянуто в замечаниях, а не переписывать текст заново. После нескольких неудачных попыток статья уходит в статус ручного разбора, а не публикуется автоматически любой ценой.
Ключевые особенности
Генератор и валидатор — разные вызовы модели. Валидатор не видит себя автором текста и не защищает уже принятые решения, что снижает шанс пропустить собственную же ошибку.
У каждого числа в статье есть источник. Цифра либо привязана к записи базы знаний, либо явно помечена как условный пример — прямая страховка от выдуманных фактов о продукте.
Смысловая и структурная проверка разделены. Валидатор отвечает за факты, язык и логику; гейт — за заполненность полей и формальные правила, без дублирования зон ответственности.
Ретрай — точечная правка, а не пересборка текста. Генератор получает конкретный список претензий и инструкцию сохранить остальное — это экономит попытки.
Ручной контент не смешивается с автогенерацией. Раздел кейсов с версткой ведут люди и он вынесен за периметр LLM-пайплайна.
Техническая реализация
Оркестрация цикла — выборка темы, сборка промптов, вызовы обеих моделей, технический гейт, запись результата — собрана в одном workflow-инструменте (n8n), без отдельного бэкенд-сервиса очередей. Для одного разработчика это осознанный компромисс: визуальный граф узлов с прямым доступом к базе данных и HTTP-вызовами к моделям собирается и отлаживается быстрее, чем полноценный воркер.
История каждой попытки генерации — какая модель вызывалась, что вернула, какой вердикт вынесли валидатор и гейт — сохраняется в базе данных, что позволяет разбирать конкретные случаи отклонения статьи постфактум.
Данные о странице и статье передаются между узлами пайплайна как структурированный JSON, а не свободный текст, — это даёт гейту и фронтенду работать с конкретными полями, не парся текст заново на каждом шаге. Поверх реестра работает отдельный API-слой для листинга, массовой смены статуса и закрепления модели генерации за страницей. Готовая статья рендерится фронтендом по той же JSON-структуре и сопровождается автоматической разметкой для поисковых систем и динамическим сайтмапом, который собирается напрямую из опубликованных страниц реестра.
Технологический стек
n8n — оркестрация всего цикла: выборка темы, промпты, вызовы моделей, гейт, запись результата, без отдельного бэкенд-воркера.
DeepSeek — генератор на первой попытке, прямой вызов API без прокси, быстрый и недорогой вариант для чистовой генерации по строгой схеме.
GPT-4.1-mini — генератор на повторной попытке и независимый валидатор готовой статьи — та же модель, но в отдельной роли и с отдельным промптом.
PostgreSQL — реестр страниц, база знаний продукта и лог каждой попытки генерации с ответами обеих моделей.
FastAPI — бэкенд-API поверх реестра: листинг с фильтрами, массовая смена статуса, назначение модели генерации.
Next.js — фронтенд, рендер статьи по JSON-структуре, разметка для поисковых систем, автоматический сайтмап.
Что получилось
Полный цикл — генерация, независимая валидация и технический гейт — занимает 30–50 секунд на статью. Это не черновик, который ещё нужно вычитывать вручную, а результат, уже прошедший три уровня проверки.
В характерном прод-прогоне из 32 статей 27 (около 85%) прошли весь цикл с первой попытки, без единого retry. На момент актуализации данных пайплайн довёл до публикации 448 из 448 страниц реестра — весь текущий бэклог обработан.
Брак, который раньше требовал ручной вычитки — выдуманные факты, обрезанные технические поля, шаблонные фразы, числа без источника, — теперь либо автоматически чинится на повторной попытке, либо статья не публикуется вовсе. До ручного разбора долетают только действительно спорные случаи, не прошедшие несколько автоматических попыток исправления.
Разметка для поисковых систем и сайтмап формируются автоматически из опубликованных страниц реестра — этот шаг больше не нужно повторять вручную для каждой статьи.
Где можно использовать
Программатик-SEO для B2B-продуктов — там, где нужно закрыть десятки или сотни страниц под разные интенты, не жертвуя фактической точностью текста.
Контент с цифрами и расчётами, где важно не потерять привязку числа к источнику — финансовые и аналитические материалы, методические статьи.
Массовая генерация текста с обязательным контролем качества — везде, где нельзя просто довериться модели и нужен независимый второй проход поверх результата.
Каталоги и справочные разделы, требующие единообразной структуры страниц при разном содержании — сравнения, глоссарии, инструкции.
Сам принцип — «пишет одна модель, проверяет другая, структуру считает код» — переносим на любую задачу генерации текста, где цена ошибки выше цены лишнего вызова API.
Нужен поток SEO-текстов без ручной проверки каждого?
Покажу, как устроен генератор с независимым валидатором, и обсудим, подойдёт ли такой пайплайн под вашу семантику.
Ещё в портфолио
KILLOOS
Интеллектуальная система бизнес-аналитики, переводит данные в управленческие решения и предупреждает риски до потерь.
Подробнее →Vizgen
Визуальный редактор для работы с контентом: генерация карточек товара, визуализация и апскейл — доставляется через REST API.
Подробнее →Georeis
Диспетчеризация доставки и приложение водителя: маршрут по фото путевого листа → оптимизированный план на день.
Подробнее →Geo101
Приложение для активных путешественников: GPX-маршруты и офлайн-навигация для трейла, эндуро и пешего туризма.
Подробнее →Kitchen 3D Planner
Планировщик кухни для мебельных компаний: подбор модулей, фасадов и техники по размерам помещения, с 3D-сборкой на выходе.
Подробнее →Driver.Georeis
Приложение для водителей Georeis: распознаёт адреса с фото путевого листа, сверяет по адресной базе и строит порядок объезда с расчётом времени прибытия.
Подробнее →DeviceHub
Единый сервис метрик для физических устройств на столе: тянет данные сразу из нескольких продуктов и отдаёт готовые экраны без перепрошивки.
Подробнее →Rilso
Рабочее место для упаковки рилсов: из сырого видео — превью, транскрипт, вшитые субтитры, обложка, текст публикации, хэштеги и архив на экспорт.
Подробнее →Лабсервер
Собственный GPU-сервер для тестирования моделей, подбора параметров и сборки MVP в закрытом контуре — без выхода данных наружу.
Подробнее →