Rilso
Рабочее место для упаковки рилсов: из сырого видео — превью, транскрипт, вшитые субтитры, обложка, текст публикации, хэштеги и архив на экспорт.
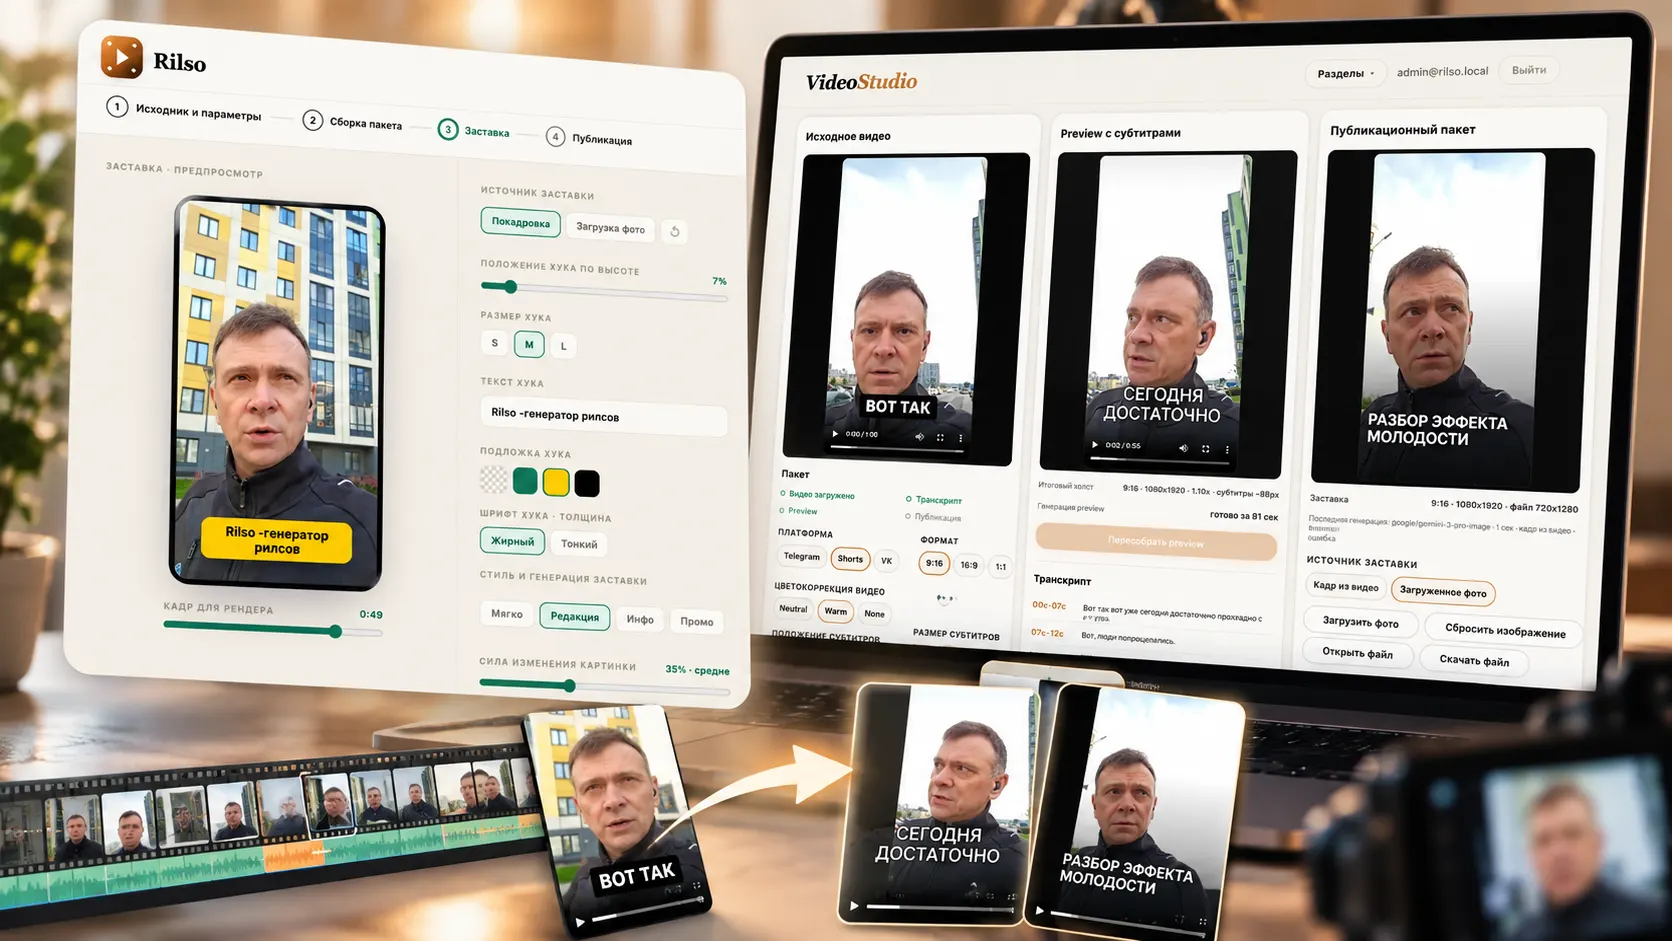
Rilso — подробно
Rilso — сервис, который собирает подготовку короткого вертикального видео (рилса) к публикации в одном месте: от загрузки сырого клипа до готового пакета с субтитрами, обложкой и текстом поста.
Раньше эти шаги обычно разбросаны по разным программам — субтитры в одном приложении, обложка в другом, текст публикации в заметках, архивация исходников вручную. Rilso объединяет всё в один процесс с живым превью на каждом шаге: то, что видно на экране при редактировании, совпадает с тем, что получится в итоговом рендере.
Продукт рассчитан на тех, кто регулярно готовит короткие ролики для соцсетей — авторов, блогеров, SMM-специалистов, небольшие контент-команды — и хочет проходить путь «сырое видео → готовый к публикации рилс» за один присест, не переключаясь между инструментами.
Внутри сервис сочетает два подхода к обработке. Там, где важны предсказуемость и контроль — монтаж, субтитры, цветокоррекция, очистка пауз — используется классическая детерминированная обработка видео и звука. Там, где нужен смысл и генерация — расшифровка речи, текст публикации, обложка — включаются AI-модели.
Задача
Подготовка рилса — это набор разрозненных шагов в разных программах: субтитры отдельно от монтажа, обложка в другом редакторе, текст поста и хэштеги вручную в заметках, архивация исходников в файловом менеджере.
Каждый шаг теряет контекст предыдущего: для субтитров заново нужен транскрипт, который уже был получен на этапе монтажа; текст публикации пишется с нуля, хотя суть ролика уже прозвучала в самой записи; обложка собирается отдельно от того, что уже отрендерено.
Есть и более узкая проблема именно коротких вертикальных роликов (формат 9:16): субтитры и текстовые элементы легко перекрывают лицо или уезжают за безопасную зону кадра, а проверить это на глаз сложно без точного совпадения превью и рендера. Ручная разметка пауз в речи отдельно отнимает время, а без неё ролик звучит рыхлым.
Решение
Общая цепочка: исходное видео → обработка (классический видео-пайплайн + AI-модули) → готовый пакет для публикации.
Пользователь загружает сырой клип в фулскрин-интерфейс и проходит несколько шагов подряд: транскрипт и субтитры, очистка звука и монтаж, текст публикации, обложка, при необходимости — удаление фона. Результат каждого шага виден сразу в превью.
Главная идея — не терять данные между шагами: транскрипт, однажды распознанный для субтитров, используется и для текста публикации, а финальный рендер и обложка складываются в один пакет с манифестом, а не остаются разрозненными файлами.
Как работает
Распознавание речи и автосубтитры. Видео прогоняется через распознавание речи, на выходе — сегменты текста с таймкодами. На их основе строится файл субтитров, который вшивается в видео с переносом строк, обводкой для читаемости и адаптивным размером шрифта. Распознавание работает на GPU с автоматическим откатом на CPU, если видеокарта недоступна; русская речь поддерживается «из коробки». Транскрипт переиспользуется дальше — для текста публикации.
Очистка звука и монтаж. Аудиодорожка анализируется на паузы — провалы громкости дольше заданного порога; такие участки вырезаются с защитным отступом, а оставшиеся куски видео и звука склеиваются без заметных швов. Транскрипт автоматически пересчитывается под новую временную шкалу, чтобы субтитры не разъезжались. Громкость нормализуется по отраслевому стандарту. Эта часть — классическая детерминированная обработка без нейросетей: задача измеримая, алгоритм быстрее и предсказуемее модели. Отдельно доступен точный контроль положения субтитров в кадре — направляющая в превью математически совпадает с тем, что печатается в рендере.
Текст публикации по смыслу видео. На основе транскрипта и выбранного стиля (экспертный / новостной / продающий) формируются заголовок, описание, текст на обложку и хэштеги — сразу готовые к публикации. Генерация выполняется языковой моделью со структурированным ответом, чтобы поля были предсказуемой структуры. Если модель недоступна или транскрипт пуст, включается запасной алгоритмический генератор на ключевых словах — функция не отказывает целиком.
Обложка. Финальная обложка собирается из кадра видео или загруженного фото, доращивается генеративной моделью под тему ролика, поверх накладывается текстовый хук с несколькими пресетами шрифтовой подачи. Используется та же AI-инфраструктура генерации изображений, что и в других продуктах автора.
Удаление фона видео. Человек отделяется от заднего плана по всему ролику, фон можно сделать прозрачным или заменить цветом. Используется модель видео-маттинга, учитывающая связность между соседними кадрами, а не независимую сегментацию каждого кадра — меньше «мерцания» границ на движении. Работает на GPU с откатом на CPU.
Сборка и экспорт пакета. Финальный рендер (субтитры, монтаж, цветокоррекция, формат под платформу) упаковывается в архив вместе с обложкой и манифестом — файлом с параметрами рендера, метаданными и хэштегами. Отдельно доступна прямая отправка готового пакета в Telegram: обложка, видео и подпись уходят одним сообщением.
Ключевые особенности
WYSIWYG-позиционирование субтитров. Направляющая в редакторе математически совпадает с тем, что печатается при рендере, — субтитры не наезжают на лицо и не уезжают за безопасную зону, результат виден заранее, а не проверяется на глаз.
Транскрипт как общий ресурс пайплайна. Речь распознаётся один раз и используется и для субтитров, и для текста публикации — контекст между шагами не теряется, как при работе в нескольких разных программах.
Отказоустойчивость AI-шагов. Распознавание речи и удаление фона работают на GPU с откатом на CPU; генерация текста при недоступности языковой модели переключается на алгоритмический запасной вариант. Ключевые функции не отказывают целиком при сбое одного компонента.
Готовый пакет, а не набор файлов. Видео, обложка и манифест с параметрами собираются в единый архив с возможностью сразу отправить результат в Telegram.
Экспериментальный модуль — голос и говорящий аватар. В проекте отдельно существуют два сервиса: один клонирует голос по короткому образцу и озвучивает им текст, второй берёт видео лица и синхронизирует движение губ со звуком. Связка «текст → голос автора → видео с синхронными губами» технически работает, но пока это два независимых инструмента, не подключённых к основному сценарию Rilso.
Техническая реализация
Продукт архитектурно разделён на два независимых контура в одном пайплайне: детерминированную обработку видео и звука (монтаж, субтитры, цветокоррекция, очистка пауз) и AI-модули (распознавание речи, генерация текста и изображений, видео-маттинг). Такое разделение держит предсказуемое поведение там, где оно нужно, и подключает генеративные модели только там, где нужен смысл или творческая генерация.
Отдельное архитектурное решение — пересчёт транскрипта при удалении пауз: после вырезания тишины временные метки сегментов транскрипта автоматически переносятся на новую шкалу, чтобы субтитры оставались синхронными с речью после монтажа.
Генерация текста публикации построена на структурированном (schema-based) ответе языковой модели, что избавляет от ручного разбора свободного текста, с деградирующим, но рабочим алгоритмическим сценарием на случай недоступности модели. AI-компоненты, требующие GPU (распознавание речи, видео-маттинг), реализованы с автоматическим откатом на CPU-инференс, что расширяет условия, при которых сервис остаётся работоспособным.
Правки «на лету» голосом или текстом («сделай субтитры ниже», «теплее картинка») реализованы не как AI-агент, а как разбор ключевых слов по заданному словарю, точечно меняющий параметры рендера — быстрый и предсказуемый механизм, но ограниченный заложенным набором команд.
Фронтенд построен как последовательность шагов одного рабочего места (источник видео → монтаж и превью → обложка → публикация) с сохранением состояния сессии между визитами. Каждый сервис — основной backend, распознавание и генерация, экспериментальные голосовые сервисы — развёрнут отдельным контейнером с собственным резервированием GPU-ресурсов, что позволяет включать и выключать ресурсоёмкие компоненты независимо друг от друга.
Технологический стек
Python, FastAPI — backend продукта, REST API для загрузки видео, рендера и сборки пакетов публикации.
Модель на основе Whisper — транскрипция речи, с GPU-инференсом и откатом на CPU.
Языковая модель (LLM) — генерация текста публикации со структурированным ответом.
Генеративная модель изображений — генерация и доработка обложек.
Модель видео-маттинга — покадровое удаление фона с учётом связности кадров.
Модель клонирования голоса — экспериментальный сервис voice cloning.
Модель синхронизации губ (lip-sync) — экспериментальный сервис говорящего аватара.
ffmpeg / ffprobe — монтаж, паддинг под формат, цветокоррекция, детект тишины, нормализация громкости, субтитры.
Pillow — покадровая отрисовка текста там, где стандартных средств недостаточно.
Next.js — фронтенд, фулскрин-рабочее место с последовательными шагами и живым превью.
Telegram Bot API — прямая публикация готового пакета в чат.
Docker — контейнеризация сервисов с раздельным резервированием GPU-ресурсов.
Что получилось
Основной рабочий процесс — от загрузки видео до готового пакета с субтитрами, обложкой, текстом публикации и хэштегами — реализован и работает в одном рабочем месте вместо нескольких разрозненных программ.
Субтитры и транскрипт получаются автоматически, без ручной расшифровки. Текст публикации и хэштеги собираются из смысла уже записанного видео с учётом выбранного тона. Положение субтитров контролируется точно, с WYSIWYG-превью, совпадающим с итоговым рендером. Готовый пакет (видео, обложка, манифест) можно выгрузить или отправить напрямую в Telegram.
Отдельно в проекте реализованы и работают как самостоятельные инструменты клонирование голоса и синхронизация губ говорящего аватара — технически связка уже способна превратить текст в видео «говорящей головы» голосом конкретного человека, но это пока не встроенный шаг основного сценария Rilso, а отдельный, ещё не подключённый к продукту прототип.
Где можно использовать
Личный контент и блогинг — регулярная подготовка коротких вертикальных видео без переключения между программами.
SMM и контент-команды — упаковка роликов клиента или бренда в единый пакет с текстом публикации, субтитрами и обложкой.
Агентства короткого видеоконтента — ускорение рутинных этапов подготовки рилсов перед публикацией в нескольких каналах.
Образовательный и экспертный контент — превращение записанных объяснений или лекций в короткие ролики с субтитрами и текстом, вытянутым из сути сказанного.
Персональный бренд — задел на клонированный голос и говорящего аватара как отдельный формат, после интеграции этих модулей в основной сценарий.
Нужна упаковка рилсов без ручной сборки по кусочкам?
Покажу, как из сырого видео получается готовый к публикации пакет.
Ещё в портфолио
KILLOOS
Интеллектуальная система бизнес-аналитики, переводит данные в управленческие решения и предупреждает риски до потерь.
Подробнее →Vizgen
Визуальный редактор для работы с контентом: генерация карточек товара, визуализация и апскейл — доставляется через REST API.
Подробнее →Georeis
Диспетчеризация доставки и приложение водителя: маршрут по фото путевого листа → оптимизированный план на день.
Подробнее →Geo101
Приложение для активных путешественников: GPX-маршруты и офлайн-навигация для трейла, эндуро и пешего туризма.
Подробнее →Kitchen 3D Planner
Планировщик кухни для мебельных компаний: подбор модулей, фасадов и техники по размерам помещения, с 3D-сборкой на выходе.
Подробнее →Driver.Georeis
Приложение для водителей Georeis: распознаёт адреса с фото путевого листа, сверяет по адресной базе и строит порядок объезда с расчётом времени прибытия.
Подробнее →OpenSEO
Генерация SEO-статей по заданной структуре — с очеловечиванием стиля и независимой валидацией результата перед публикацией.
Подробнее →DeviceHub
Единый сервис метрик для физических устройств на столе: тянет данные сразу из нескольких продуктов и отдаёт готовые экраны без перепрошивки.
Подробнее →Лабсервер
Собственный GPU-сервер для тестирования моделей, подбора параметров и сборки MVP в закрытом контуре — без выхода данных наружу.
Подробнее →