Лабсервер
Собственный GPU-сервер для тестирования моделей, подбора параметров и сборки MVP в закрытом контуре — без выхода данных наружу.
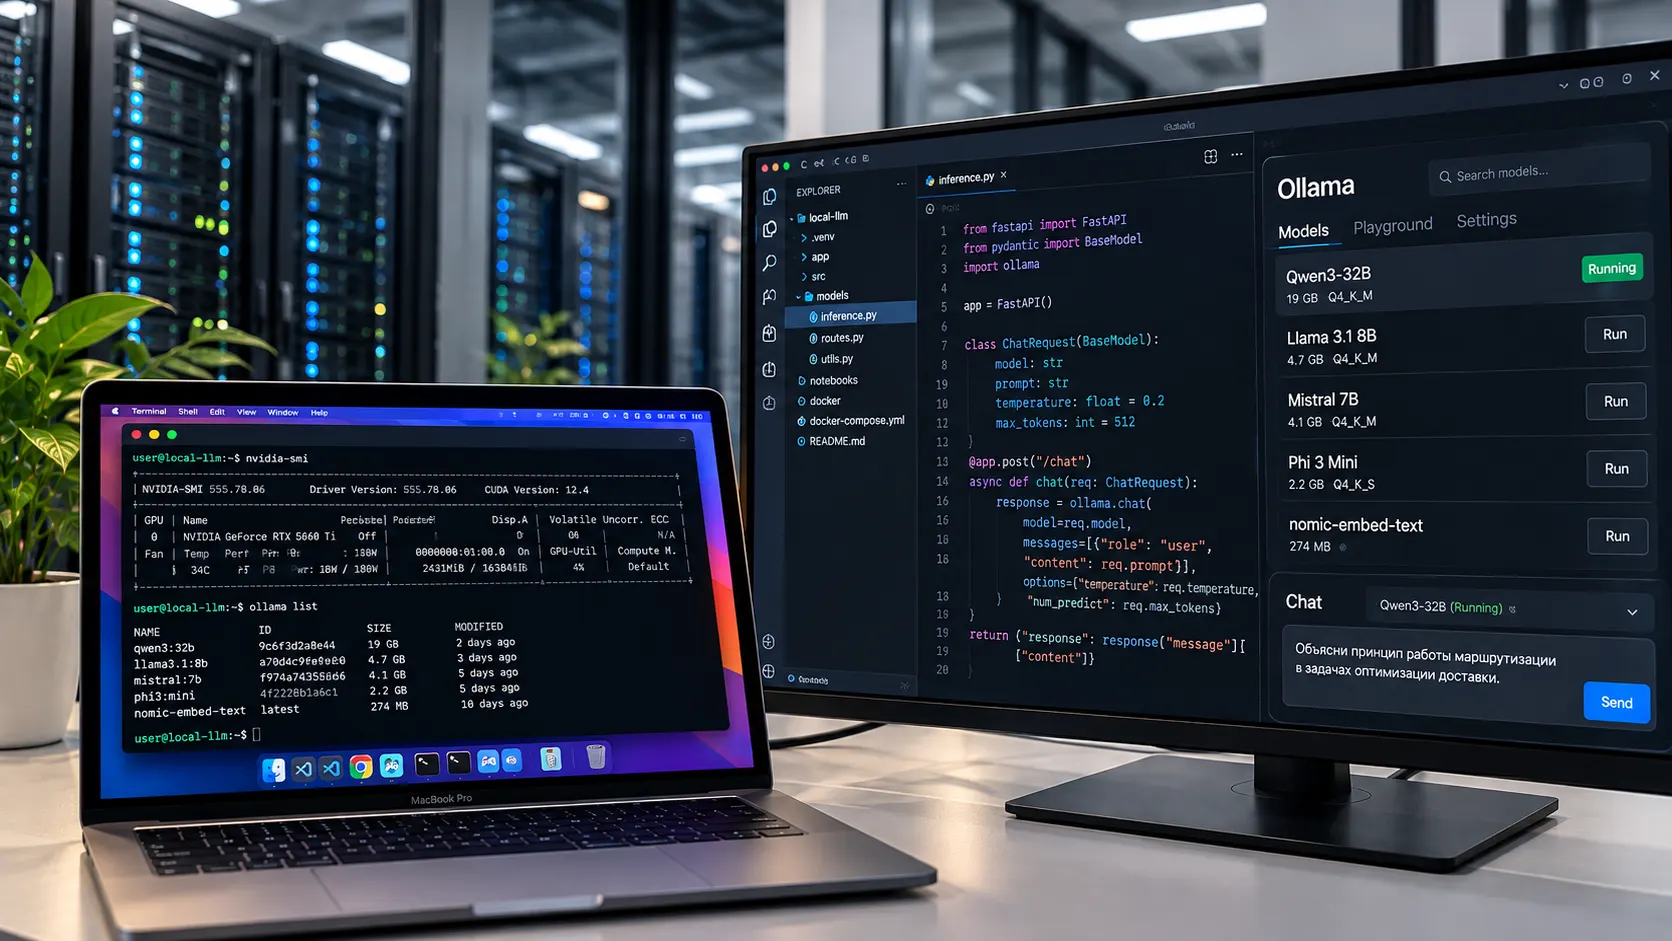
Лабсервер — подробно
Лабсервер — собственная серверная инфраструктура на физической машине с видеокартой, которая служит приватной площадкой для экспериментов с AI-моделями и общей базой сервисов для нескольких работающих продуктов.
На сервере совмещены два слоя. Первый — реальные AI-сервисы: локальное распознавание текста с фотографий (vision-модель) и локальный перевод текста, оба прогнаны и протестированы на практике. Второй — инфраструктура, без которой эти сервисы остались бы разовыми скриптами: оркестрация сценариев, хранилище файлов, база данных, мониторинг и BI-визуализация.
Идея простая: прежде чем платить за модель во внешнем API и отправлять туда чужие данные, эксперимент можно прогнать на своём железе — сколько угодно раз, без счётчика токенов и без вопроса, куда уходят фотографии или тексты клиентов.
Сервер не разовая демонстрация «у нас есть GPU» — это действующая инфраструктура, на которую уже опираются несколько проектов одновременно.
Задача
Перебор моделей через внешние API упирается в два системных ограничения.
Первое — стоимость: чтобы понять, какая модель точнее решает задачу (например, читает адрес с фотографии), нужно прогнать десятки вариантов на разных промптах и настройках, и каждый прогон через внешний API стоит денег независимо от итогового результата.
Второе — данные. Пока архитектура решения не устоялась, экспериментальные прогоны часто идут на реальных, а не тестовых материалах — фотографиях, черновиках, рабочих данных. Отправлять их наружу на этапе, когда решение ещё не готово к продакшену, особенно нежелательно для задач с персональными данными вроде адресов и маршрутов. Дополнительно через разные внешние API сложно поставить чистый эксперимент «модель A против модели B на одинаковом входе»: у каждого провайдера своя очередь, лимиты и скрытые задержки, искажающие сравнение.
Ответ на эти ограничения — сервер под собственным контролем, полностью прозрачный и не тарифицируемый по количеству запросов.
Решение
Архитектурная цепочка:
Задача продукта (фото, текст, данные) → AI-сервис на собственном GPU → приватная внутренняя сеть → оркестрация и API → результат в продукте / отчёт.
AI-сервисы — распознавание изображений и перевод текста — делят одну видеокарту: после ответа модель выгружается из памяти, освобождая место для соседней задачи (на той же карте отдельно работает и генерация изображений для другого продукта). Вокруг них выстроен инфраструктурный слой: оркестратор собирает шаги в воспроизводимый сценарий, хранилище и база данных дают общее место для данных нескольких проектов, мониторинг показывает состояние ресурсов в реальном времени. Доступ ко всем внутренним сервисам закрыт приватной сетью — наружу публикуется только то, что должно быть публичным.
Как работает
Распознавание адресов с фотографий
Сервис принимает фотографию или скриншот со списком адресов — например, маршрутный лист, который приходит водителю или диспетчеру снимком, а не текстом, — и извлекает из неё структурированный список адресов для геосервиса, где такие фото — обычная часть работы.
На сервере прогнаны и напрямую сравнены две версии модели распознавания (компактная и более крупная), обе локально, без обращения к внешнему API, на одинаковых реальных фотографиях и условиях запуска.
Перевод текста для генеративных пайплайнов
Отдельный сервис переводит текст между русским и английским языками — как прослойка перед локальными генеративными моделями, которые точнее работают с промптами на английском: текст переводится перед подачей в модель и, при необходимости, обратно. Модель перевода открытая и полностью локальная, без обращения к внешним API.
Оркестрация сценариев
Сервис-оркестратор собирает шаги в воспроизводимый сценарий: загрузка файла → обращение к одной или нескольким моделям → сравнение с эталоном → отчёт. Им же обрабатываются входящие вебхуки и часть коммуникации с внешними API. Развёрнут на собственном сервере, а не в облачной версии, поскольку сценарии обращаются к внутренним сервисам напрямую.
Общее хранилище и база данных
Файловое хранилище, совместимое по протоколу с S3, хранит медиафайлы нескольких проектов — например, входные фотографии для vision-сервиса и изображения, сгенерированные для другого продукта. Отдельная база данных используется как приватное хранилище для постепенного переноса данных проектов с облачных провайдеров на собственную инфраструктуру.
BI-аналитика поверх приватных данных
Тестовый контур аналитической визуализации подключён к внутренней базе данных и пока обкатывается на синтетических данных для тестового розничного сценария — отрабатывается методология витрин и детализации показателей перед подключением реальных данных клиента.
Мониторинг и управление ресурсами
Панель управления контейнерами позволяет запускать, останавливать и смотреть логи сервисов без прямого доступа к серверу — например, быстро выгрузить тяжёлую модель, когда она не нужна. Мониторинг показывает загрузку процессора, памяти, диска и видеокарты в реальном времени, включая занятую видеопамять — критично, когда несколько GPU-нагрузок работают на одной карте.
Ключевые особенности
Закрытый периметр. Модели, база данных, хранилище и панель аналитики доступны только внутри приватной сети и не имеют публичного адреса — наружу публикуется только то, что действительно должно быть доступно снаружи.
Воспроизводимое сравнение моделей. Версии модели распознавания сравнены на одинаковых реальных данных и условиях запуска — результат выражен в конкретных цифрах, а не в оценке на глаз.
Совместное использование GPU разными задачами. Распознавание, перевод и генерация изображений работают на одной видеокарте; выгрузка модели из памяти сразу после ответа — осознанное решение, чтобы задачи не конфликтовали за видеопамять.
Единая база для нескольких проектов. Хранилище, база данных и оркестрация общие для нескольких продуктов — не нужно поднимать инфраструктуру заново под каждую новую задачу.
Прозрачность вместо чёрного ящика. В отличие от внешнего облачного GPU-провайдера здесь напрямую видно, какая модель что считает и сколько видеопамяти занято.
Техническая реализация
Сервисы развёрнуты как независимые контейнеры под единым инструментом контейнеризации — каждый можно запускать, обновлять и изолировать отдельно от остальных. Видеокарта проброшена в контейнеры через стандартный механизм доступа GPU в Docker, что даёт AI-сервисам прямой доступ к вычислениям без промежуточных слоёв.
Модель распознавания изображений запускается через локальный раннер моделей, который загружает и выгружает веса из видеопамяти по запросу — ключевой механизм, позволяющий нескольким моделям по очереди использовать одну карту без постоянного резервирования памяти под каждую. Модель перевода сконвертирована в оптимизированный для инференса формат, что даёт заметно более низкую задержку по сравнению с запуском исходной модели «как есть».
Доступ к внутренним сервисам организован через приватную сеть: наружу выведены только те сервисы, которым это необходимо по назначению, весь остальной трафик — модели, база данных, хранилище, аналитика — маршрутизируется внутри периметра. База данных организована по принципу отдельной схемы на каждый проект, что позволяет постепенно переносить данные разных продуктов на общую инфраструктуру, не смешивая их между собой.
Технологический стек
GPU и рантайм
- Видеокарта потребительского уровня — вычислительная основа для локальных моделей
- Docker + проброс GPU в контейнеры — изоляция и доступ к видеокарте для каждого сервиса
AI и модели
- Ollama — локальный раннер моделей, запуск и выгрузка vision-модели по запросу
- CTranslate2 — оптимизированный инференс модели перевода
- Открытые модели распознавания изображений и перевода текста — без обязательной отправки данных во внешние API
Данные и хранилище
- PostgreSQL — приватная база данных, отдельная схема на каждый проект
- MinIO — S3-совместимое объектное хранилище, общие медиафайлы нескольких проектов
Оркестрация и аналитика
- n8n — движок автоматизаций и AI-сценариев без написания backend-кода под каждый workflow
- Apache Superset — BI-визуализация поверх приватной базы данных
Сеть и периметр
- Приватная VPN-сеть между рабочими машинами и сервером — единственный путь доступа к внутренним сервисам
- Обратный прокси с TLS-сертификатом — единственная публичная точка входа
Управление и мониторинг
- Portainer — управление контейнерами через веб-интерфейс
- Netdata — мониторинг ресурсов хоста и видеокарты в реальном времени
Что получилось
Развёрнута и работает собственная GPU-инфраструктура, на которой прогнаны и протестированы два реальных AI-сервиса: распознавание адресов с фотографий и перевод текста между русским и английским языками — оба без обращения к внешним API.
Для сервиса распознавания зафиксирован прямой бенчмарк двух версий модели на одинаковых реальных фотографиях: компактная модель оказалась быстрее (несколько секунд на прогон против почти вдвое большего времени у крупной) и с усиленным промптом не теряла строки текста там, где их теряла модель побольше. Оговорка: сравнение сделано на ограниченном наборе фотографий, и перед переключением рабочего продукта распознанные адреса в любом случае требуют сверки через внешние справочники — как уже устроено при работе с адресными данными.
Вокруг AI-сервисов работает общая инфраструктурная база — приватная сеть, хранилище, база данных, оркестрация и мониторинг, — на которую уже опираются несколько продуктов. Отдельно развёрнут тестовый контур BI-аналитики — пока на синтетических данных, как отработка методологии перед подключением реальных.
Где можно использовать
Подбор AI-модели перед выбором внешнего провайдера. Прямое сравнение нескольких моделей на одинаковых данных перед тем, как платить за конкретный внешний API в продакшене.
Обработка чувствительных данных на этапе прототипа. Задачи, где на вход идут фотографии, документы или тексты, которые нежелательно отправлять во внешние сервисы до готовности решения.
Общая инфраструктура для нескольких небольших продуктов. Хранилище, база данных и оркестрация без необходимости поднимать их заново под каждый новый проект.
Приватный BI-слой поверх собственных данных. Аналитическая визуализация без выноса коммерческих показателей в облачный BI-сервис.
Тестовая площадка перед продакшен-развёртыванием AI-функции. Обкатка модели или пайплайна на реальных условиях перед подключением к боевому продукту.
Нужно обкатать идею на данных, которые нельзя выпускать наружу?
Расскажу, как собрать и протестировать MVP в закрытом контуре — без утечки данных и без счетов за каждый эксперимент.
Ещё в портфолио
KILLOOS
Интеллектуальная система бизнес-аналитики, переводит данные в управленческие решения и предупреждает риски до потерь.
Подробнее →Vizgen
Визуальный редактор для работы с контентом: генерация карточек товара, визуализация и апскейл — доставляется через REST API.
Подробнее →Georeis
Диспетчеризация доставки и приложение водителя: маршрут по фото путевого листа → оптимизированный план на день.
Подробнее →Geo101
Приложение для активных путешественников: GPX-маршруты и офлайн-навигация для трейла, эндуро и пешего туризма.
Подробнее →Kitchen 3D Planner
Планировщик кухни для мебельных компаний: подбор модулей, фасадов и техники по размерам помещения, с 3D-сборкой на выходе.
Подробнее →Driver.Georeis
Приложение для водителей Georeis: распознаёт адреса с фото путевого листа, сверяет по адресной базе и строит порядок объезда с расчётом времени прибытия.
Подробнее →OpenSEO
Генерация SEO-статей по заданной структуре — с очеловечиванием стиля и независимой валидацией результата перед публикацией.
Подробнее →DeviceHub
Единый сервис метрик для физических устройств на столе: тянет данные сразу из нескольких продуктов и отдаёт готовые экраны без перепрошивки.
Подробнее →Rilso
Рабочее место для упаковки рилсов: из сырого видео — превью, транскрипт, вшитые субтитры, обложка, текст публикации, хэштеги и архив на экспорт.
Подробнее →